We hebben al veel tijd gestoken in lokale taalmodellen op de R9700. Maar een werkstation hoeft niet bij chat en code te stoppen. Wat als dezelfde kaart een afbeelding kan omzetten in een object dat u van alle kanten kunt bekijken?
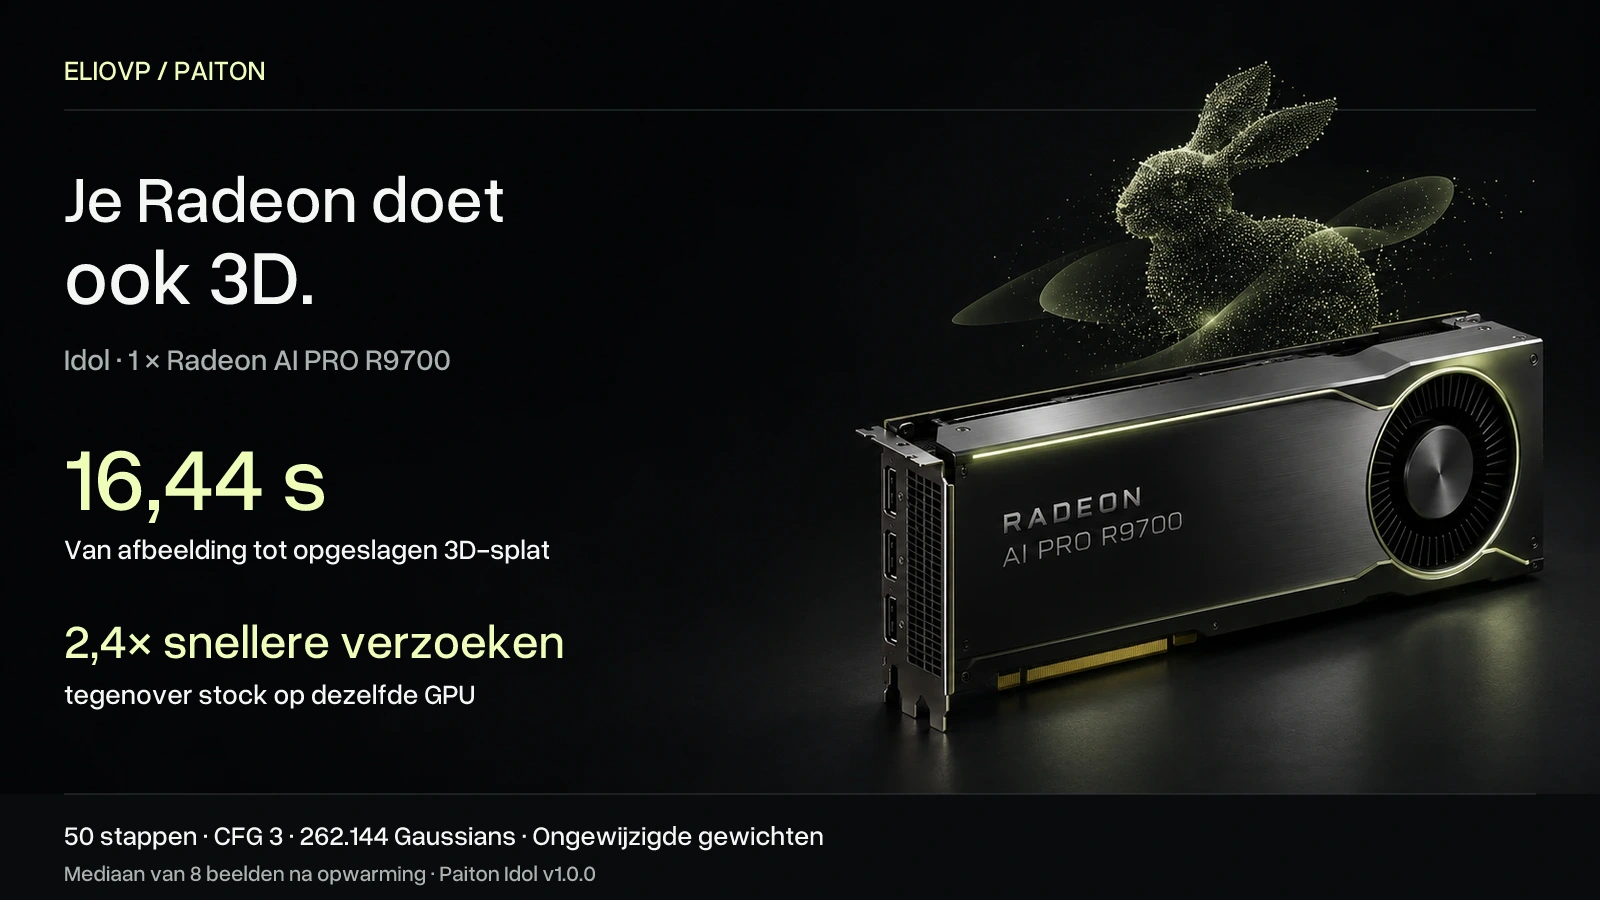
Dat doet Idol van Sperid Labs. Geef het één afbeelding en het genereert een 3D Gaussian splat, inclusief een aannemelijke achterkant die nooit op het beeld stond. Met Paiton duurt een volledig verzoek 16,4 seconden op één Radeon AI PRO R9700. Standaard-Idol heeft op dezelfde kaart 39,2 seconden nodig: ongeveer 2,4× sneller, met dezelfde gewichten, 50 stappen en guidance-instelling.1
Ter vergelijking: Sperid Labs rapporteert afzonderlijk 19,1 seconden op een RTX 4090. Een interessant referentiepunt, geen gecontroleerde vergelijking tussen GPU-fabrikanten. Hieronder laten we zien wat we maten, wat eruit komt en hoe u het zelf probeert.
In dit artikel
- Van één afbeelding naar een draaibaar object
- De meting op dezelfde GPU en de kwaliteitscontrole
- Andere GPUs en een indicatieve prijsvergelijking
- Zelf lokaal draaien
Van beeld naar object
De header is een illustratie; deze animatie toont een echte uitvoer van de uitgebrachte Paiton-bundel op één R9700, met 262.144 Gaussians. Links: invoer gegenereerd met FLUX.2 klein 4B. Rechts: het resultaat van Idol van alle kanten. Origineel voorbeeld en herkomst.
De uitvoer is een standaard 3DGS-.ply, geen getextureerde polygonenmesh. Open het bestand in een Gaussian-splatviewer om het object te verkennen. De onzichtbare kanten zijn gegenereerd, niet teruggewonnen metingen van het oorspronkelijke object. Dat maakt dit interessant voor visuele ideeën en previews, niet als vervanging voor een nauwkeurige scan.
Met zo'n snelle rondblik ziet u makkelijker wat werkt aan een personage of object, en waar een andere invoerafbeelding zou helpen.
Van 39,2 naar 16,4 seconden
Mediaan van acht afbeeldingen na één opwarmverzoek. Elk verzoek omvat invoerverwerking, generatie en het opslaan van de PLY. Eén R9700, 262.144 Gaussians, 50 stappen, CFG 3,0 en tijdverschuiving 3,0.
| Runtime op één R9700 | Volledig verzoek | Gemiddelde LPIPS tegenover standaard geoptimaliseerd |
|---|---|---|
| Standaard-Idol, geoptimaliseerde standaardmodus | 39,22 s | Referentie |
Paiton --exact | 19,45 s | 0,0027 |
| Paiton standaard | 16,44 s | 0,0039 |
Dat is ongeveer 58% minder wachten. Downloads, opstarten en het opwarmverzoek vallen buiten de meting. De referentie gebruikt het geoptimaliseerde PyTorch-pad van idol-sdk op ROCm, geen bewust trage basislijn. De GPU behoudt zijn standaardlimiet van 300 W, zonder aanpassingen aan klok, vermogen of ventilator. Die limiet is geen gemeten energieverbruik.1
Het meeste werk zit in de denoiser. Paiton vervangt die door een native HIP/C++-runtime voor RDNA4 gfx1201; de rest blijft draaien op de oorspronkelijke idol-sdk en PyTorch. Matrixproducten blijven fp16. Het standaardprofiel schakelt attention vanaf stap 7 over op int8 QK en fp8 PV; --exact behoudt overal fp16-attention.2
Hoeveel verandert dat aan het resultaat? Voor de release zijn acht objecten vanuit acht aanzichten per object vergeleken met renders van standaard-Idol. De gemiddelde LPIPS was 0,0039 voor het standaardprofiel, 0,0027 voor exact en 0,0026 tussen de geoptimaliseerde en niet-geoptimaliseerde standaardimplementatie. Lager betekent dichter bij elkaar. Het standaardprofiel haalde ook de PSNR-grens voor het slechtst scorende object: 34,63 dB bij een minimum van 33 dB.1
Dit is een afgebakende kwaliteitscontrole, geen controle van elke toekomstige uitvoer. --exact blijft dicht bij de verschillen tussen de standaardimplementaties, maar belooft geen identieke bits of bitreproduceerbaarheid tussen runs. De piek van het door PyTorch gereserveerde GPU-geheugen was 9,6 GiB voor beide Paiton-profielen en 10,7 GiB voor standaard-Idol. Dat meet niet het volledige GPU-gebruik en kwalificeert geen kleinere kaarten.
Waar de R9700 uitkomt
R9700-metingen: ElioVP. Andere GPUs: de modelkaart van Sperid Labs. Beide rapporteren 50 stappen, 262.144 Gaussians en medianen over acht afbeeldingen, maar het zijn afzonderlijke metingen, geen gecontroleerde hardwarevergelijking.
| GPU en runtime | Verzoek | Bron |
|---|---|---|
| H100 80 GB, variant niet vermeld | 6,7 s | Sperid Labs |
| RTX 5090 | 14,1 s | Sperid Labs |
| R9700, Paiton standaard | 16,44 s | ElioVP |
| L40S | 16,6 s | Sperid Labs |
| RTX 4090 | 19,1 s | Sperid Labs |
| R9700, standaard-Idol | 39,22 s | ElioVP |
| RTX 3080 10 GB | 46,2 s | Sperid Labs |
Met deze gepubliceerde tijden haalt de R9700 ongeveer 86% van de berekende verzoekdoorvoer van de RTX 5090. Het cijfer ligt dicht bij dat van de L40S. Zo'n klein verschil tussen afzonderlijke opstellingen levert echter geen betrouwbare rangschikking op.3
En het hardwarebudget?
Berekend als 3.600 ÷ verzoektijd in seconden ÷ aangenomen GPU-prijs × 1.000. Een indicatieve vergelijking van alleen de GPU, geen doorvoertest van een uur. Hostkosten, energie en diensten zijn niet inbegrepen.
| GPU | Aangenomen prijs, USD | Berekende objecten/uur per $1.000 |
|---|---|---|
| R9700, Paiton standaard | $1.900 | 115,3 |
| RTX 3080 10 GB | $710 | 109,7 |
| RTX 5090 | $3.300 | 77,4 |
| RTX 4090 | $4.800 | 39,3 |
| L40S | $7.570 | 28,6 |
| H100 80 GB | $31.000 | 17,3 |
Dit zijn de prijsaannames uit de gepubliceerde README voor november 2026, geen onafhankelijk bevestigde laagst beschikbare prijzen. De H100-prijs betreft PCIe-hardware, terwijl de upstreammeting geen variant vermeldt. Vooral die rij is dus een benadering.2
Bij de aannames van $1.900 en $4.800 kost de R9700 ongeveer 40% van de RTX 4090. Prijzen kunnen de rangschikking veranderen: de RTX 3080 zit hier al dichtbij. Reken met uw eigen offerte, zeker als u al een geschikte GPU hebt.
Probeer het op uw R9700
U hebt Linux, Docker, een werkend AMD-stuurprogramma en de geteste R9700 nodig. Accepteer eerst de DINOv3-licentie op Hugging Face en gebruik daarna een token van dat account. Houd echte tokens privé; hf_... hieronder is alleen een voorbeeldwaarde.2
docker pull ghcr.io/eliovp/paiton-vllm-plugin:idol-rdna4-v1.0.0

export HF_TOKEN=hf_...
mkdir -p "$HOME/paiton-idol/models" "$HOME/paiton-idol/outputs"
docker run --rm --device /dev/kfd --device /dev/dri --group-add "$(stat -c '%g' /dev/kfd)" \
  -e HF_TOKEN -v "$HOME/paiton-idol/models:/models" -v "$HOME/paiton-idol/outputs:/outputs" -v "$PWD:/inputs:ro" \
  ghcr.io/eliovp/paiton-vllm-plugin:idol-rdna4-v1.0.0 generate /inputs/photo.png --mode real
Plaats photo.png in uw huidige map. Gebruik --mode synthetic voor renders of gegenereerde afbeeldingen, zoals in de benchmark. Voeg --exact toe om fp16-attention te behouden. De standaardinstellingen zijn 50 stappen, CFG 3,0, seed 42 en 262.144 Gaussians.
De eerste run downloadt de gewichten; volgende runs hergebruiken de modelmap. In $HOME/paiton-idol/outputs verschijnen een .ply, de voorbereide _input.png en een _camera.json. Voor een vastgezette containerreferentie: op 6 november 2026 verwees de openbare tag naar deze registry-digest:
ghcr.io/eliovp/paiton-vllm-plugin@sha256:7939b4e0bcacf49bcce51d71892915eda802ad2f3724ef61e06e1bc7a77b4e5d
Vervang de tag in beide Docker-commando's door die referentie om het image vast te zetten. De openbare releasehandleiding beschrijft het starten en downloaden.
De pakketcode en uitgebrachte native runtime vallen onder Apache-2.0; de compiler van Paiton blijft gesloten. Idol en de FLUX.2 klein-VAE hebben Apache-2.0-voorwaarden, terwijl DINOv3 zijn eigen licentie behoudt. De gewichten worden afzonderlijk gedownload.4
Weer een nuttige toepassing voor hetzelfde lokale werkstation. Ontdek Paiton, onze lokale beeldgeneratie of Sovereign AI om deze workflows op uw eigen infrastructuur te houden.