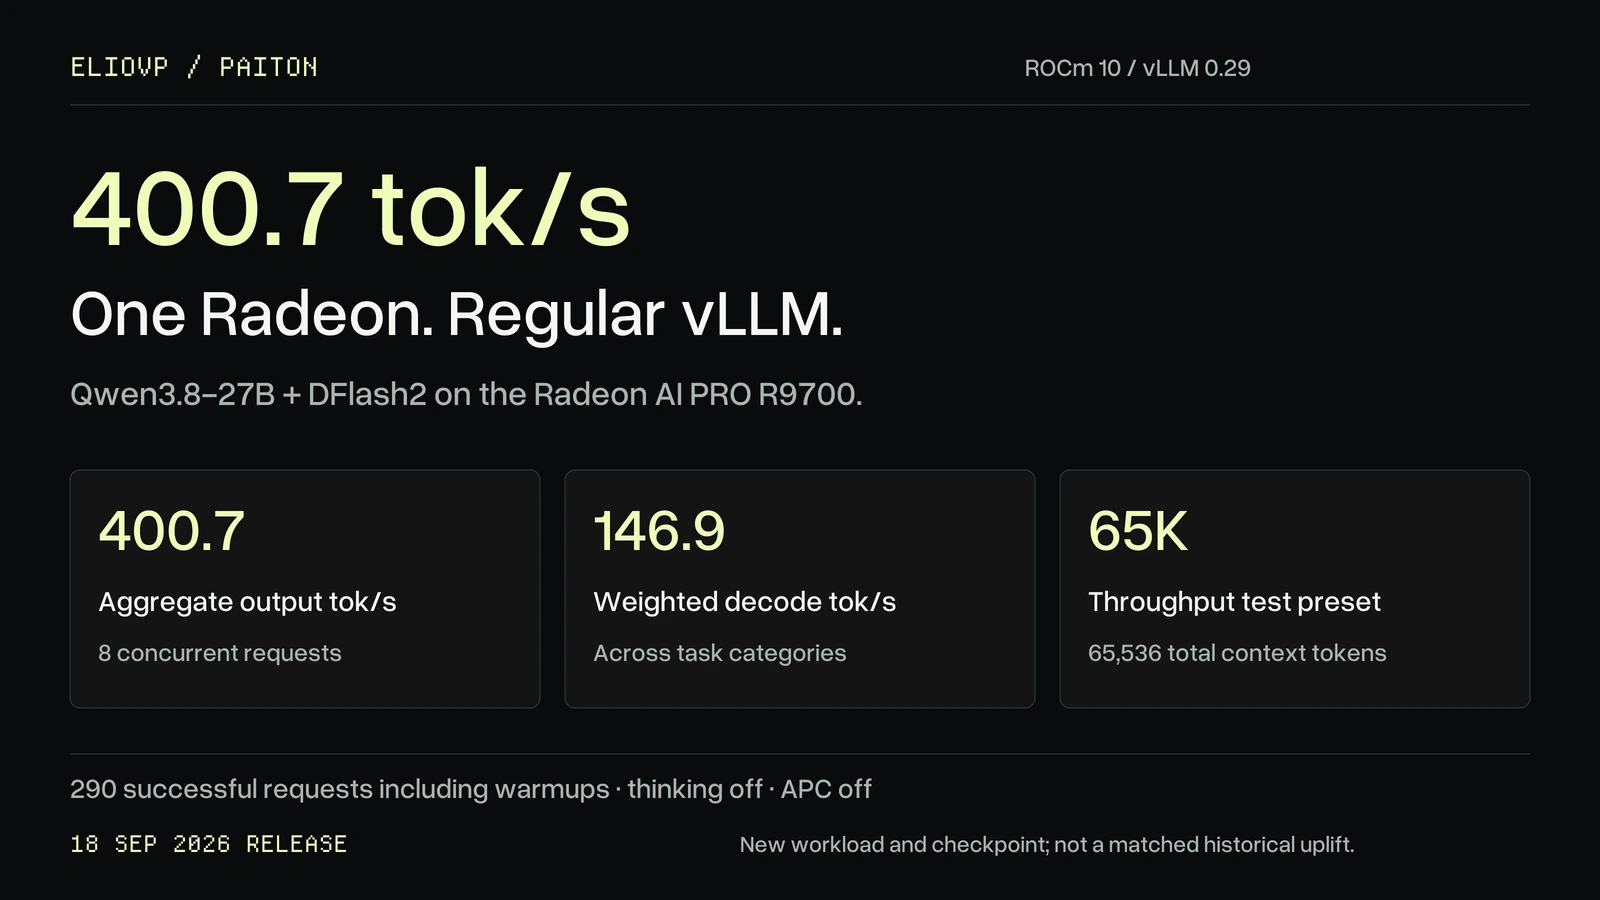
400,7 uitvoertokens per seconde in totaal op één Radeon AI PRO R9700. De release van 18 september gebruikt ROCm 10 en vLLM 0.29.0, met een 65K-preset voor doorvoer en instelbare profielen voor lange gesprekken. De gewogen decodesnelheid is 146,9 tok/s; de categorie JSON haalt 215,9 tok/s.1
Bijgewerkt op 19 september 2026. Bekijk de actuele benchmark, 200K/220K-gesprekken met prefixcaching of de actuele startinstructies. De oorspronkelijke 57%-vergelijking en de experimenten van 17 september blijven hieronder bewaard als historische onderbouwing.
Een nieuwe release, geen nieuw gecontroleerd winstpercentage. Deze run gebruikt unsloth/Qwen3.8-27B-NVFP4 via het MXFP4-runtimepad, niet het eerdere AMD-checkpoint. Ook de runtime, sampling en workload zijn gewijzigd. We delen 400,7 daarom niet door een ouder resultaat om een gelijkwaardige snelheidswinst tegenover Radiance of de vorige Paiton-release te claimen.
Actuele release: 400,7 tok/s op één R9700
De cijfers komen uit één volledige validatierun met BetterBench 0.6.0: 290 geslaagde verzoeken inclusief opwarmruns, op één R9700 met 32 GB en een vermogenslimiet van 300 W. De preset met 65.536 tokens werd getest met thinking en APC uitgeschakeld. Sampling: temperatuur 0,7, top-p 0,95, top-k 20 en seed 42. Een vermogenslimiet is geen gemeten elektriciteitsverbruik.1
65K-releasepreset; 48 verzoeken per gelijktijdigheidsniveau. Totale uitvoer gedeeld door verstreken tijd, niet de decodesnelheid per gebruiker. Gepubliceerde tabellen · Grafiekgegevens. De grafieklabels zijn Engels; de tabel hieronder is Nederlands.
| Gelijktijdige verzoeken | Totale uitvoer in tok/s |
|---|---|
| 1 | 115,0 |
| 2 | 203,2 |
| 4 | 296,5 |
| 8 | 400,7 |
Decode over verschillende taken
De gewogen decodescore is 146,9 tok/s. Per categorie zijn er vijf beoordeelde runs na één opwarmrun. Het JSON-resultaat is een categoriescore, niet de algemene snelheid die elke gebruiker krijgt.
| Categorie | Mediane decode in tok/s |
|---|---|
| Chat | 123,7 |
| Code | 169,2 |
| Bestanden bewerken | 185,0 |
| JSON | 215,9 |
| Wiskunde | 182,7 |
| Proza | 74,9 |
| Redeneren | 112,5 |
| Samenvatten | 115,0 |
Prefill bij langere prompts
BetterBench deelt het werkelijke aantal prompttokens door de tijd tot het eerste token. Per diepte zijn er acht beoordeelde runs na twee opwarmruns. De gevraagde diepte is niet gelijk aan de werkelijk getokeniseerde invoer.
| Gevraagde diepte | Mediaan werkelijk aantal prompttokens | Mediane prefill in tok/s |
|---|---|---|
| 2.000 | 1.516,5 | 3.503,6 |
| 8.000 | 5.894,5 | 3.530,4 |
| 16.000 | 11.802,0 | 3.536,9 |
| 32.000 | 23.549,5 | 3.393,0 |
| 64.000 | 47.016,5 | 3.113,0 |
Dit zijn metingen van de 65K-configuratie, niet van doorvoer bij 200K. “65K” betekent 65.536 contexttokens, hetzelfde aantal dat eerder “64K” werd genoemd. Alleen die naam betekent dus geen groter contextvenster.
Lange gesprekken: prefixcaching die je kunt proberen
Met de nieuwe publieke launchers is context een instelling bij het starten, geen vast ingebouwde imagelimiet. De context omvat de prompt, chat- en toolopmaak en gegenereerde uitvoer. VRAM en het ondersteunde modelbereik blijven beperkingen. Acht ingeplande verzoeken betekenen niet dat acht volledige 65K-gesprekken tegelijk passen.
| Actuele startkeuze | Totale context | Maximaal ingeplande verzoeken | APC |
|---|---|---|---|
| 65K-releasepreset | 65.536 | 8 | Uit |
| 200K-releasepreset | 200.000 | 1 | Uit |
| Chatprofiel | 200.000; override getest tot 220.000 | 1 | Aan, experimentele configuratie |
| Desktopprofiel | 32.768 | 1 | Uit |
Het chatprofiel is nu publiek uitvoerbaar. Het hergebruikt ongewijzigde gespreksgeschiedenis met prefixcaching, een KV-pool van 8 GiB, prefill-chunks van 1.024 tokens en thinking uitgeschakeld. Gebruik een dedicated R9700: er blijft weinig VRAM over. Dit is een andere configuratie dan de doorvoerbenchmark; APC staat niet standaard aan in de releasepresets.1
In één retrievaltest met een contextinstelling van 220K werd een prompt van 215.005 tokens afgehandeld in 130,00 seconden zonder cache en 1,77 seconden bij een identieke herhaling, met hergebruik van 213.840 gecachete tokens. Beide antwoorden telden negen tokens bij temperatuur nul. Dit zijn volledige responstijden uit één functionele test, geen TTFT, algemene latentiegarantie of snellere decode. Ook retrieval met een gewijzigde prefix, twee langere antwoorden, een volgende XML-toolaanroep en een nieuw kort verzoek slaagden. Dit is geen brede kwaliteitsvalidatie voor lange gesprekken.
Een afzonderlijke test van de 200K-image slaagde met 198.989 prompttokens gevolgd door generatie en gewone en gestreamde XML-toolaanroepen. De grootste geteste contextinstelling is 220.000, niet de architecturale modelgrens van 262.144 tokens.
Cachehits vereisen een ongewijzigde prefix die nog in het geheugen aanwezig is. Ze besparen herhaald promptwerk, niet het genereren van elk nieuw token. Opstartcaches op schijf staan hier los van. Het chatprofiel rapporteert usage.prompt_tokens_details.cached_tokens; streamingclients hebben ook "stream_options":{"include_usage":true} nodig.
Voor een GPU die ook desktopapplicaties draait, begint --profile desktop kleiner: 2 GiB cache en één ingepland verzoek. Dat garandeert niet dat het geheugen altijd volstaat. Alleen de context verlagen verkleint geen vaste KV-toewijzing. Deze launchers zijn alleen voor tekst. De afzonderlijke beeldtest is geen vrijgegeven multimodaal 200K/220K-profiel.
Start de ROCm 10-release
Gebruik Linux x86-64, Python 3, Docker, de Hugging Face CLI en één Radeon AI PRO R9700 met 32 GB en werkende AMD-GPU-toegang. Haal de publieke repository op en voer de opdrachten uit vanuit de hoofdmap. Voor reproduceerbaarheid volgt dit artikel commit 8f56157c05eb6a53f6cdab00a115e47b42fed2d1. De launchers leggen de images vast via een onveranderlijke digest. Gebruik voor deze release niet het oude AMD-checkpoint of de historische automatische downloader.
Selecteer de GPU via de gedocumenteerde ROCm-zichtbaarheidsvariabelen. Die worden ongewijzigd doorgegeven; controleer bestaande maskers in plaats van indices blind te combineren. Zie de GPU- en geheugeninstellingen. Draai slechts één profiel tegelijk op de kaart.
Start het 200K-chatprofiel
Deze opdrachten downloaden de exacte snapshots van doel- en draftmodel en starten de server op de voorgrond. De eerste image-download is ongeveer 9,6 GB, exclusief gewichten. Bij het starten worden gewichten geladen/geconverteerd en runtimecomponenten gecompileerd. Wacht tot de server klaar is voordat je prestaties meet. Volgende starts hergebruiken de blijvende cache; een private compilercheckout is niet nodig.
Versietagghcr.io/eliovp/paiton-vllm-plugin:qwen38-rocm10-vllm029-200k-20260918-r2sha256:32dab97330ea84b86967537d25f91878c30f21ff844f71369508c5a049b89178
export PAITON_TARGET_DIR="$PWD/model-cache/qwen38-nvfp4"
export PAITON_DRAFT_DIR="$PWD/model-cache/qwen38-dflash2"
export PAITON_CACHE_DIR="$PWD/runtime-cache/qwen38-rocm10-200k"
mkdir -p "$PAITON_TARGET_DIR" "$PAITON_DRAFT_DIR" "$PAITON_CACHE_DIR"

hf download unsloth/Qwen3.8-27B-NVFP4 \
  --revision f0b7c9e722f5565102fff8481c99e4d86ae099c7 \
  --local-dir "$PAITON_TARGET_DIR"
hf download tcclaviger/Qwen3.8-27B-DFlash2-FP8 \
  --revision ee0cb26a8279b7910cc28d82a8a3e15e4728d56f \
  --local-dir "$PAITON_DRAFT_DIR"

bash models/Qwen3.8-MXFP4-DFlash2/run-rocm10-200k.sh --profile chat --context 200000
De API gebruikt http://127.0.0.1:18982/v1 en modelnaam Qwen3.8, niet de historische poort en modelnaam verderop:
curl --fail http://127.0.0.1:18982/health
curl --fail http://127.0.0.1:18982/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.8","messages":[{"role":"user","content":"Write a Python function that removes duplicate items while preserving order."}],"temperature":0.7,"top_p":0.95,"max_tokens":256,"stream":true,"chat_template_kwargs":{"enable_thinking":false}}'
Kies de 65K-benchmarkpreset
Stop eerst de andere server met docker stop paiton-qwen38-200k. Behoud dezelfde modelmappen en gebruik:
Versietagghcr.io/eliovp/paiton-vllm-plugin:qwen38-rocm10-vllm029-65k-20260918-r2sha256:a896b5deca21e95771cd0057d27f3cb0f6ede95cb1146a7a78c883b9ae7d8444
export PAITON_CACHE_DIR="$PWD/runtime-cache/qwen38-rocm10-65k"
mkdir -p "$PAITON_CACHE_DIR"
bash models/Qwen3.8-MXFP4-DFlash2/run-rocm10-65k.sh
Stel thinking expliciet in om de benchmark te volgen. De modeltemplate van de releasepreset schakelt thinking in wanneer de client niets opgeeft. Het chatprofiel en de benchmarks schakelen het uit. Gebruik --thinking off als serverstandaard of "chat_template_kwargs":{"enable_thinking":false} per verzoek.
Voor 220K-gesprekken stop je de draaiende server en gebruik je bash models/Qwen3.8-MXFP4-DFlash2/run-rocm10-200k.sh --profile chat --context 220000. Gebruik het volledige chatprofiel; ga er niet van uit dat alleen APC inschakelen de geheugenvereisten onveranderd laat. De publieke handleiding beschrijft de geteste instellingen en beperkingen.
Oorspronkelijke vergelijking van 16 september
Historische scope: de vergelijking hieronder gebruikt het eerdere AMD-checkpoint, vLLM 0.28 en de gelijk opgezette 8K-configuratie. De winst van 57% blijft geldig voor die tests, maar is geen procentuele claim voor de ROCm 10-release.
Eén Radeon AI PRO R9700. Hetzelfde Qwen3.8-27B MXFP4-checkpoint. Dezelfde 5 GiB voor de cache. Paiton levert 57% meer totale doorvoer dan onze vergelijkbare Radiance + DFlash2-referentie bij acht gelijktijdige verzoeken. De mediane tijd tot het eerste token daalt van 6,59 seconden naar 195 milliseconden.
De kerncijfers voor doorvoer en responstijd komen uit de oorspronkelijke, gelijk opgezette vergelijking met 188 verzoeken, bij acht gelijktijdige verzoeken en een contextlimiet van 8.192 tokens. Beide versnelde engines gebruiken dezelfde snapshots van het doelmodel en het DFlash2-draftmodel. De GPU-afbeelding is illustratief.
Dit is een flinke stap vooruit voor het aanbieden van een 27B-model op één workstation-GPU. Het gaat niet alleen om snellere generatie voor één gebruiker: er kunnen meer verzoeken tegelijk vooruitgang boeken, de geschatte cachecapaciteit is bijna drie keer zo groot en de wachttijd onder belasting is veel korter.
Paiton haalt 314,5 uitvoertokens per seconde in totaal, tegenover 200,3 tok/s voor de vergelijkbare versnelde referentie. De gewogen seriële decodesnelheid stijgt met 22% en prefill is sneller bij elke geteste promptlengte. De uitvoering loopt via een plugin op de officiële vLLM 0.28 ROCm-runtime. De geïnstalleerde vLLM-bibliotheek blijft ongewijzigd.2
Het waardevolle zit in die combinatie: duidelijk betere lokale prestaties, met behoud van de reguliere vLLM-deployment.
Bekijk het in actie
Historische opname van de oorspronkelijke release, geen demonstratie van de nieuwe ROCm 10-benchmark of het 220K-chatprofiel.
Bekijk hoe Qwen3.8 antwoorden genereert op één Radeon AI PRO R9700, met Paiton + DFlash2 via regulier vLLM. De opname toont de gestreamde uitvoer, live generatiecijfers en GPU-activiteit.
Schermopname van 70 seconden met telkens één actief verzoek. De live cijfers gelden voor de getoonde verzoeken, niet voor de totale doorvoer bij acht gelijktijdige verzoeken in de benchmark hieronder.
Open de opname (MP4, 10,2 MB). Gebruik de knop voor volledig scherm om alles van dichtbij te bekijken.
Een sterke referentie. Een beter resultaat.
Het onderzoek begon met het indrukwekkende werk rond vLLM-Radiance. De resultaten op AMD-hardware brachten ons op ideeën en moedigden ons aan onze eigen R9700-implementatie verder te optimaliseren. De publieke documentatie beschrijft ondersteuning voor hetzelfde AMD Quark MXFP4-model en DFlash2-versnelling. De gepubliceerde prestatiecijfers van dat project gebruiken twee R9700's.3
Radiance inspireerde dit onderzoek. Paitons native HIP-integratie bevat aangepaste technieken uit Radiance en libr4d, met bronvermelding in de publieke vermeldingen van derden.
Onze vraag was: hoeveel kunnen we met dit model uit één kaart halen, met behoud van de reguliere vLLM-deployment?
Daarom hebben we Radiance + DFlash2 en Paiton op vLLM + DFlash2 zelf op één R9700 getest. Beide gebruikten hetzelfde checkpoint, dezelfde snapshots van doel- en draftmodel, een FP8-KV-cache, een cachetoewijzing van 5 GiB en een contextlimiet van 8.192 tokens. De twee versnelde profielen gebruikten zeven speculatieve tokens, greedy sampling en uitgeschakelde prefixcaching.2
Onze winstpercentages vergelijken die gelijk opgezette tests op één GPU. We vergelijken dus geen resultaat op één kaart met een extern gepubliceerd resultaat op twee kaarten.
57% meer doorvoer, met een grotere voorsprong onder belasting
Het hoofdresultaat komt uit de volledige BetterBench-preset met 188 verzoeken, niet uit de kortere vergelijking met maximaal 128 uitvoertokens. We behielden de oorspronkelijke, ruimere uitvoerbudgetten van de preset, met tien gemeten herhalingen per taakcategorie, 24 verzoeken per getest gelijktijdigheidsniveau en herhaalde prefill-metingen. Beide engines voltooiden alle verzoeken.24
Volledige workload met 188 verzoeken, runs 495 / 494. De totale doorvoer omvat prefill en wachtrijtijd. Hoger is beter.2
| Gelijktijdige verzoeken | Radiance + DFlash2 | Paiton op vLLM + DFlash2 | Winst met Paiton |
|---|---|---|---|
| 1 | 76,9 tok/s | 89,6 tok/s | 16,5% |
| 2 | 142,7 tok/s | 165,7 tok/s | 16,1% |
| 4 | 187,1 tok/s | 254,8 tok/s | 36,2% |
| 8 | 200,3 tok/s | 314,5 tok/s | 57,0% |
Paiton loopt voor bij elk getest gelijktijdigheidsniveau. Ook de resultaten per taakcategorie laten een voorsprong zien voor code, redeneren, proza, JSON, bestandsbewerking, samenvatten, wiskunde en chat. De winst houdt dus stand in de langere workload en hangt niet af van één gunstige prompt.2
Dit zijn totale verwerkingssnelheden voor de actieve workload. 314,5 tok/s betekent niet dat elk van de acht gebruikers 314,5 tok/s ontvangt.
Van 6,59 seconden wachten naar een eerste token in 195 milliseconden
De winst in doorvoer is groot. De verbetering in responsiviteit onder belasting is nog groter.
Bij vier gelijktijdige verzoeken daalt de mediane tijd tot het eerste token van 1.627 ms naar 180 ms. Bij acht daalt die van 6.586 ms naar 195 ms: 97% korter. Deze tijden zijn inclusief wachtrijtijd en beschrijven dus hoe lang de client wacht voordat het antwoord begint.2
Volledige workload met 188 verzoeken. Lager is beter. Bij één en twee gelijktijdige verzoeken behoudt Radiance een TTFT-voordeel van 10 tot 11 ms. Paiton levert bij beide niveaus wel meer doorvoer.2
Voor een gedeelde programmeerassistent of een lokaal endpoint voor agents is doorvoer alleen niet genoeg. Een endpoint dat meer tokens produceert maar verzoeken lang laat wachten voordat de generatie begint, kan nog steeds traag aanvoelen. Hier gaat de hogere doorvoer bij meer gelijktijdige verzoeken samen met een veel kortere wachttijd tot het eerste token.
Dezelfde 5 GiB biedt bijna drie keer de tokencapaciteit
Met precies 5 GiB gereserveerd per engine rapporteren de runtimes 25.746 cachetokenslots voor Radiance en 74.430 voor Paiton. Dat is 2,89× de geschatte tokencapaciteit binnen dezelfde geheugentoewijzing.2
Door de runtime gerapporteerde schattingen van de gedeelde cachecapaciteit, geen fysieke VRAM-capaciteit. In de oorspronkelijke benchmarkconfiguratie was de contextlimiet per verzoek 8.192 tokens.2
De logs van deze tests tonen maximaal drie actieve verzoeken voor Radiance en acht voor Paiton binnen de vergelijkbare configuratie. Dat zijn waarnemingen uit deze runs, geen algemene limieten voor het aantal gelijktijdige verzoeken van beide engines.2
Die extra capaciteit helpt de betere ervaring bij gelijktijdig gebruik te verklaren: meer verzoeken kunnen binnen hetzelfde geheugenbudget vooruitgang boeken. De capaciteitscijfers en het waargenomen aantal actieve verzoeken passen bij de gemeten doorvoer en responstijd. Ze bewijzen niet dat alleen het cachebeheer de verbetering veroorzaakt.
Meer bruikbare capaciteit voor verzoeken, niet meer VRAM of een groter contextvenster.
Snellere decode en prefill, over de hele workload
De winst beperkt zich niet tot het tegelijk toelaten van meer verzoeken. In de volledige workload stijgt de gewogen seriële decodesnelheid van 86,0 naar 104,9 uitvoertokens per seconde: 22% hoger. Dit meet de generatie na het eerste token en staat los van de totale doorvoer voor de volledige workload hierboven.2
Gewogen seriële decodesnelheid voor de volledige workload. Dezelfde snapshots van doel- en draftmodel op dezelfde R9700.2
Ook prefill verbetert bij elke geteste promptlengte. Bij ongeveer 1.556 / 3.024 / 5.226 invoertokens haalt Radiance 2.828 / 3.003 / 2.926 invoertokens per seconde. Paiton haalt 3.182 / 3.521 / 3.367 invoertokens per seconde.2
Prefill voor de volledige workload: 12,5%, 17,2% en 15,1% hoger, berekend op basis van de getoonde samenvattingswaarden. Dit is het werkelijke aantal prompttokens gedeeld door de HTTP-tijd tot het eerste token, geen geïsoleerde kerneldoorvoer.2
Samen laten deze resultaten verbetering zien op meerdere momenten die een gebruiker merkt: de prompt verwerken, onder belasting aan het antwoord beginnen en de rest van het antwoord genereren.
Het verschil met standaard-vLLM is groot
Daarnaast testten we een afzonderlijke matrix met 54 verzoeken en maximaal 128 uitvoertokens. Daarin vergeleken we standaard-vLLM O2, Radiance + DFlash2 en Paiton op vLLM + DFlash2. Voor standaard-vLLM gebruikten we de beste O2-instellingen die we hadden getest.2
| Gelijktijdige verzoeken | Standaard-vLLM O2 | Radiance + DFlash2 | Paiton op vLLM + DFlash2 |
|---|---|---|---|
| 1 | 4,5 tok/s | 78,0 tok/s | 90,0 tok/s |
| 2 | 8,8 tok/s | 151,2 tok/s | 160,5 tok/s |
| 4 | 17,4 tok/s | 189,2 tok/s | 231,5 tok/s |
| 8 | 33,7 tok/s | 175,6 tok/s | 328,5 tok/s |
Totale uitvoerdoorvoer in de afzonderlijke matrix met 54 verzoeken en een uitvoerlimiet van 128 tokens, runs 403 / 493 / 492. Waarden uit de gepubliceerde benchmarksamenvatting. Deze vergelijking is niet de bron van het hoofdresultaat van 57%.2
Bij acht gelijktijdige verzoeken stijgt de totale doorvoer van 33,7 tok/s met standaard-vLLM naar 328,5 tok/s met Paiton, bijna een vertienvoudiging. De gewogen seriële decodesnelheid in deze kortere vergelijking stijgt van 4,5 naar 113,5 tok/s.2
De reikwijdte van die vergelijking is belangrijk. Standaard-vLLM gebruikt W4A4-emulatie volgens het checkpoint, terwijl de versnelde configuraties W4A8-uitvoering met DFlash2 gebruiken. Dit zijn volledige engineconfiguraties met dezelfde gewichten, niet identieke berekeningen voor activaties. De cijfers betekenen ook niet dat het vervangen van één kernel de volledige winst oplevert, of dat dit resultaat geldt voor elk model of elke kwantisatie op standaard-vLLM.
Prefill in de afzonderlijke matrix met beperkte uitvoerlengte, op basis van de werkelijke getokeniseerde promptlengtes. Deze waarden horen niet bij de prefill-reeks voor de volledige workload hierboven.2
Daarom baseren we het hoofdresultaat op de zwaardere vergelijking: Paiton tegenover een al versnelde Radiance + DFlash2-referentie, bevestigd in de langere workload.
Regulier vLLM. De geïnstalleerde bibliotheek blijft intact.
Die deploymentvorm is een bewuste keuze. Paiton integreert via de uitbreidingsmechanismen van vLLM en levert native HIP-runtimebestanden voor de geoptimaliseerde uitvoering. Het pluginsysteem van vLLM is bedoeld om uitbreidingen mogelijk te maken zonder de codebase aan te passen.25
De geoptimaliseerde uitvoering gebruikt Paitons native HIP-kernels en DFlash2-integratie. De release bundelt de benodigde runtimebestanden voor de geteste deployment, inclusief de DFlash2-integratie, zodat gebruikers geen apart DFlash-pakket hoeven te installeren. Onze Paiton-compiler blijft gesloten.26
Voor de oorspronkelijke v1.0.0-release controleerden we ook de reguliere API-server via vllm.entrypoints.openai.api_server, los van de benchmarkomgeving. Die slaagde voor streamingchat, acht gelijktijdige verzoeken, een verzoek op de ingestelde contextgrens van 8K en een nieuw verzoek daarna. Alle 2.893 geïnstalleerde vLLM-bestanden kwamen overeen met de officiële basisimage. Deze validatie geldt voor de vastgelegde geteste runtime en het ondersteunde profiel, niet voor elke vLLM-functie of toekomstige versie.2
Standaard-vLLM behoudt zijn gebruikelijke frameworkafhankelijkheden. De native bibliotheken van Paiton laden onafhankelijk van die frameworks. Dat maakt niet de volledige serving-stack frameworkvrij.
Dat alle verzoeken worden voltooid en de API-controles slagen, is nuttig om de betrouwbaarheid te toetsen. Het is geen onafhankelijke evaluatie van de modelnauwkeurigheid of garantie op identieke gegenereerde tekst tussen uitvoeringsprofielen.
Meer uitvoer uit hetzelfde actieve uur
De doorvoercijfers bij acht gelijktijdige verzoeken uit de volledige workload maken de capaciteitswinst concreet. Een volgehouden snelheid van 200,3 tok/s zou ongeveer 721.000 uitvoertokens per actief uur opleveren. Bij 314,5 tok/s is dat ongeveer 1,13 miljoen: zo'n 411.000 extra uitvoertokens in hetzelfde uur.
Anders uitgedrukt: één miljoen uitvoertokens kost bij de referentiesnelheid 1,387 actieve uren, tegenover 0,883 uur met Paiton. Dat is 36,3% minder actieve tijd.
Rekenvoorbeeld op basis van de doorvoer bij acht gelijktijdige verzoeken in de volledige workload. Het veronderstelt dat die snelheden worden volgehouden. Dit is geen meting van een uur, geen energiemeting en geen claim over financiële kosten.2
De hardware verandert niet. Hoeveel nuttig werk die hardware kan leveren wel.
Oorspronkelijke benchmarkconfiguratie
| Onderdeel | Vergelijkbaar testprofiel |
|---|---|
| GPU | Eén Radeon AI PRO R9700, gfx1201 |
| Doelcheckpoint | amd/Qwen3.8-27B-Quark-AWQ-MXFP4 |
| Versnelde profielen | Radiance + DFlash2; Paiton op officieel vLLM + DFlash2 |
| Serving-basis voor Paiton | Officiële vLLM 0.28 ROCm-runtime |
| Cache | FP8-KV; precies 5 GiB gereserveerd per engine |
| Contextlimiet | 8.192 tokens per verzoek |
| Geteste gelijktijdige verzoeken | 1, 2, 4 en 8 |
| Speculatieve generatie | Dezelfde snapshots van doel- en draftmodel; zeven speculatieve tokens |
| Sampling | Greedy |
| Prefixcaching | Uitgeschakeld |
| Workload voor hoofdresultaat | Volledige preset met 188 verzoeken en oorspronkelijke uitvoerbudgetten |
| Aanvullende vergelijking met standaard-vLLM | Afzonderlijke matrix met 54 verzoeken en maximaal 128 uitvoertokens |
Deze resultaten gelden voor het geteste model, de runtime en de workload. Ze bieden geen garantie voor andere GPU's, langere contexten, andere draftmodellen of niet-geteste aantallen gelijktijdige verzoeken.2
Langere gesprekken: twee vrijgegeven profielen
Archief van 17 september: deze v1.1.0-profielen zijn niet de actuele ROCm 10-images. Gebruik de actuele startinstructies voor de nieuwste release.
Het oorspronkelijke resultaat beantwoordt een prestatievraag bij een context van 8K. Een praktisch endpoint voor programmeerwerk heeft ook ruimte nodig voor documenten, gespreksgeschiedenis en toolresultaten. De v1.1.0-images van 17 september breiden de beschikbare serving-profielen uit zonder de vastgelegde modelgewichten of bestaande native bibliotheken te veranderen.7
| Profiel | Totale context | FP8-cachebudget | Limiet actieve sequenties |
|---|---|---|---|
| 64K v1.1.0 | 65.536 tokens | 5 GiB | Maximaal 8, afhankelijk van de beschikbare cache |
| 200K v1.1.0 | 200.000 tokens | 8 GiB | 1 |
De context omvat het volledige tokenbudget van het verzoek: de getokeniseerde prompt, chat- en toolopmaak en de gegenereerde uitvoer. Reserveer ruimte voor het antwoord. Acht ingeplande sequenties betekent niet dat acht gesprekken van de volledige 64K-lengte tegelijk passen. Langere verzoeken gebruiken meer cache en kunnen in de wachtrij belanden of herberekening vereisen.
Dit zijn praktische serving-profielen, niet het architecturale maximum van het model. Het doel- en draftmodel vermelden 262.144 posities, maar de volledige serving-stack moet naast de gewichten, cache en het werkgeheugen passen. Het 200K-profiel heeft weinig VRAM-reserve op de R9700 met 32 GB en verwerkt één actief verzoek; andere verzoeken wachten. Behoud de meegeleverde instellingen voor prefill-blokken van 4.096 tokens en gelijktijdige verwerking.78
Een laatste controle van de verpakte image haalde drie markeringen terug uit een synthetische prompt van 195.999 tokens, met een antwoord van 57 tokens. Dat is een afgebakende functionele controle van het 200K-profiel, geen brede validatie van redeneren of programmeren met lange context. Deze controle staat los van de doorvoerbenchmarks. Ook twee ingediende prompts van 62.983 tokens werden op de 64K-image succesvol verwerkt, met gebruik van de wachtrij. Dat toont niet aan dat twee volledige contexten tegelijk in het geheugen passen.8
Toolaanroepen die de client bereiken
De oorspronkelijke parser sloot niet aan op Qwens XML-formaat voor tools. Toolsyntaxis kon als gewone antwoordtekst verschijnen in plaats van als de gestructureerde API-aanroep die een client nodig heeft om een tool uit te voeren. De nieuwe images corrigeren die verwerking aan de serverkant met qwen3_xml voor toolparsing en qwen3 voor reasoning-parsing.78
In deze v1.1.0-images van 17 september is thinking standaard uitgeschakeld. Applicaties kunnen het per verzoek inschakelen met "chat_template_kwargs": {"enable_thinking": true}. Dat verandert het gedrag van het verzoek, niet de modelgewichten of de bytes van de native bibliotheken.
Beide gecorrigeerde images slaagden voor de gepubliceerde API-tooltests met en zonder streaming. Afzonderlijk slaagde de gecorrigeerde 64K-configuratie voor een daadwerkelijke controle van het lezen en schrijven van bestanden met OpenCode 1.18.31. Dit zijn afgebakende API- en clientcontroles, geen claim over algemene autonome programmeervaardigheid. De onderbouwing van de tooltests beschrijft wat wel en niet is getest.
De 64K-image in een benchmark met korte prompts
Met de gecorrigeerde standaardinstellingen draaiden we de korte BetterBench-workload met 52 verzoeken op één R9700. Bij acht gelijktijdige verzoeken leverde de 64K-image 304,10 uitvoertokens per seconde in totaal, een mediane generatiesnelheid van 67,81 tok/s per verzoek en een mediane tijd tot het eerste token van 350,84 ms aan de clientkant.8
Bekijk de benchmarkgegevens
| Gelijktijdige aanvragen | Mediaan per aanvraag tok/s | Gezamenlijke throughput tok/s | Mediane TTFT ms |
|---|---|---|---|
| 1 | 99,95 | 84,42 | 106,29 |
| 2 | 89,55 | 152,69 | 168,05 |
| 4 | 86,16 | 230,76 | 182,87 |
| 8 | 67,81 | 304,10 | 350,84 |
Bronnen:Openbaar benchmarkrapportBrongegevens (JSON)Aanvraagresultaten (JSON)
Deze drie maten beantwoorden verschillende vragen. De generatiesnelheid per verzoek meet de uitvoer na de eerste gestreamde update; de totale doorvoer meet de voltooide uitvoer tijdens de fase met gelijktijdige verzoeken, inclusief prefill. De TTFT aan de clientkant meet het wachten op de eerste respons, inclusief HTTP en wachttijd op de server, maar exclusief de semafoor waarmee de client het aantal gelijktijdige verzoeken begrenst.
Dit zijn resultaten met korte prompts op een image die 64K ondersteunt, geen generatie met prompts van 64K. De prompts in de gelijktijdigheidstest telden 69 tot 116 tokens. Er waren 10 opwarmverzoeken die niet meetelden, een uitvoerlimiet van 128 tokens en geen verzoekfouten of preëmpties. 37 van de 52 gemeten antwoorden bereikten de limiet. Succesvolle verzoeken en deze snelheden tonen dus niet aan hoe goed volledige taken worden afgerond.
De nieuwe image schakelt thinking standaard uit; de eerdere release gebruikte de thinking-standaard van het checkpoint. Dat verandert de gegenereerde inhoud, lengtes en acceptatie van speculatieve tokens. Dit is geen gecontroleerde vergelijking van snelheidswinst ten opzichte van de eerdere release en vervangt het oorspronkelijke resultaat van 57% niet. Bekijk het volledige rapport en de methode, de samenvatting en de resultaten per run.
Groeiende gesprekken: verwerk dezelfde geschiedenis niet opnieuw
Onderzoek van 17 september. De metingen en beschikbaarheid hieronder beschrijven de oudere v1.1.0-images en experimentele adapter. Het nieuwe publieke chatprofiel staat hierboven. Pas de oude cachebeperking voor 200K niet toe op dat afzonderlijk geteste profiel.
Een programmeeragent verstuurt vaak het gesprek tot dan toe opnieuw: instructies, eerdere antwoorden, bestandsfragmenten en toolresultaten, plus één nieuwe beurt. Met automatische prefixcaching (APC) kan de server een ongewijzigd, gecachet begin hergebruiken in plaats van die geschiedenis opnieuw te verwerken. Dat kan meer verschil maken voor de wachttijd vóór een antwoord dan de decodesnelheid alleen.
Dank aan de bijdrager uit de community die deze leemte aanwees en de tijdelijke oplossing demonstreerde. Onze eerdere benchmarks met nieuwe prompts maten niet de kosten van het herhaald verwerken van een groeiende geschiedenis. APC is het bestaande hergebruikmechanisme van vLLM; het nieuwe onderzoek meet de integratie met Paiton en de bijbehorende afwegingen.9
Bij ongeveer 40K prompttokens verkortte het publiek reproduceerbare stock-GDN APC-pad de wachttijd tot het antwoord begon van 15,58 seconden bij een koude start naar 1,13 seconden bij herhaling. Het compacte pad met APC uit bleef de herhaalde geschiedenis verwerken. Een experimentele native-prefill-APC-variant verkortte de wachttijd ook, onder meer bij groeiende vervolgverzoeken.
Bekijk de benchmarkgegevens
| Aanvraagstap | Compact native, APC uit s | Stock GDN, APC aan s | Experimentele native prefill, APC aan s |
|---|---|---|---|
| Koud | 13,984786 | 15,578310 | 14,679737 |
| Identieke herhaling | 14,063400 | 1,133075 | 1,089112 |
| Uitbreidende vervolgvraag 1 | 14,203211 | 1,230756 | 1,178926 |
| Uitbreidende vervolgvraag 2 | 14,387746 | 1,386401 | 1,325764 |
| Aanvraagstap | Primaire prefix s | Onafhankelijke controle s |
|---|---|---|
| Koud | 88,458190 | 88,610754 |
| Identieke herhaling | 2,043831 | 2,032992 |
| Uitbreidende vervolgvraag 1 | 2,146838 | Niet gerapporteerd |
| Uitbreidende vervolgvraag 2 | 2,540300 | Niet gerapporteerd |
Bronnen:Openbaar benchmarkrapportBrongegevens (JSON)Aanvraagresultaten (JSON)
Het afzonderlijke experiment rond 150K gebruikte een cache van 8 GiB, een ingestelde context van 160.000 tokens en één actief verzoek. De experimentele native-prefill-adapter verkortte de TTFT van 88,46 seconden bij een koude start naar 2,04 seconden bij herhaling. Een onafhankelijke herhaling met een tweede, andere prefix kwam uit op 88,61 naar 2,03 seconden. Dat zijn 43 tot 44× kortere wachttijden tot het begin van een antwoord bij cachehits, geen snellere decode, vergelijking met een concurrent of standaardvoordeel van de gepubliceerde image. De langste geteste prompt telde 150.645 tokens. Dit valideert dus geen gebruik van de volledige 160K of 200K.9
Wat op 17 september beschikbaar was
- De v1.1.0-images van 17 september hebben APC standaard uitgeschakeld. Het compacte native pad van die release ondersteunt geen hergebruik van prefixes.
- Stock-GDN APC kun je proberen via de gepubliceerde profielaanpassing en reproductie-instructies. Dat recept gebruikt de vastgelegde 64K-image, een cache van 5 GiB en één actief verzoek.
PAITON_PREFIX_CACHING=1wordt niet meegeleverd in deze images. Alleen die gemaksschakelaar instellen activeert APC niet; gebruik de gedocumenteerde profielaanpassing.- De native-prefill-APC-adapter is experimenteel en niet vrijgegeven. De gemeten resultaten zijn niet te reproduceren met alleen de gepubliceerde image en het profiel.
Een keuze per workload, met echte afwegingen
Het huidige stock-state-terugvalpad heeft lagere gemeten decodeprestaties en minder bruikbare cachecapaciteit dan het compacte pad met APC uit. Hergebruik van een lange geschiedenis kan nog steeds veel wachttijd besparen, maar nieuwe prompts, gewijzigde tokens aan het begin, verwijdering uit de cache en serverherstarts vereisen nieuwe verwerking. De 40K-vergelijkingen gebruikten hetzelfde budget van 5 GiB; het 150K-paneel is een afzonderlijk experiment met 8 GiB, geen vergelijking met een gelijk cachebudget tegenover het compacte pad.
Pas stock-state-APC niet toe op het vrijgegeven 200K-profiel met de bestaande cache van 8 GiB. In de vastgelegde capaciteitsberekening is dat budget onvoldoende bij een contextlimiet van 200K. Dit was een afwijzing op basis van de capaciteitsberekening, geen waargenomen GPU-geheugentekort tijdens uitvoering. Een grotere toewijzing is nog niet getest.9
De gepubliceerde controles op het terugvinden van informatie, tools met gecachete context en groeiende geschiedenis vormen nuttige onderbouwing, geen brede certificering van modelkwaliteit of robuustheid. Het APC-rapport bevat de controlevarianten, controles bij cachemissers, gemeten afwegingen en beperkingen. De praktische les is om het gesprek te meten, niet alleen hoe snel het volgende antwoord wordt gegenereerd.
Aan de slag op je R9700
Historische opdrachten om de resultaten van 16/17 september te reproduceren. Gebruik voor nieuwe deployments de ROCm 10-instructies hierboven, met het nieuwe checkpoint, de nieuwe launchers en de gewijzigde API-poort.
Gebruik Linux x86-64, Docker en één Radeon AI PRO R9700 met werkende toegang tot de AMD-GPU. Begin met de gepubliceerde starthandleiding, het GHCR-pakket en de bijgewerkte Hugging Face-repository. Die laatste behoudt de ongewijzigde native overlay van v1.0.0; de nieuwe serving-profielen zijn de GHCR-images van v1.1.0.107
Draai slechts één profiel tegelijk op de GPU. Beide nieuwe commando's delen het permanente cachevolume voor modellen en binden de API aan localhost. Bij de eerste start worden het vastgelegde doel- en draftmodel gedownload en geverifieerd. Wacht tot het opstarten is voltooid voordat je het endpoint gebruikt; stop de gekozen container voordat je van profiel wisselt. Je hoeft geen compilerbroncode op te halen of iets te bouwen.
Historisch 64K-v1.1.0-profiel
Versietagghcr.io/eliovp/paiton-vllm-plugin:qwen38-mxfp4-dflash2-rdna4-v1.1.0
docker run --rm -d --name paiton-qwen38-agentic-64k \
  --device /dev/kfd --device /dev/dri --group-add video \
  --shm-size 2g -p 127.0.0.1:8000:8000 \
  -v paiton-qwen38-mxfp4-cache:/models/cache \
  ghcr.io/eliovp/paiton-vllm-plugin@sha256:c3ec2528285b484b2e0af7f571f80f1da23c1970210e4d3d09f5d2a909414186
Historisch 200K-v1.1.0-profiel
Eén actief verzoek, een cache van 8 GiB en weinig VRAM-reserve. Behoud de meegeleverde instellingen voor gelijktijdige verwerking en prefill.
Versietagghcr.io/eliovp/paiton-vllm-plugin:qwen38-mxfp4-dflash2-rdna4-200k-v1.1.0
docker run --rm -d --name paiton-qwen38-agentic-200k \
  --device /dev/kfd --device /dev/dri --group-add video \
  --shm-size 2g -p 127.0.0.1:8000:8000 \
  -v paiton-qwen38-mxfp4-cache:/models/cache \
  ghcr.io/eliovp/paiton-vllm-plugin@sha256:28af1731cfd8aceab51915411e8f879531128c2711b4193c76c5b6eba8ba2ef4
Controleer of de server klaar is met curl --fail http://127.0.0.1:8000/health. Gebruik basis-URL http://127.0.0.1:8000/v1 en modelnaam Qwen3.8-27B-Quark-AWQ-MXFP4. Zo schakel je thinking expliciet in voor één verzoek:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.8-27B-Quark-AWQ-MXFP4","messages":[{"role":"user","content":"Explain the tradeoffs of prefix caching."}],"temperature":0,"max_tokens":256,"stream":true,"chat_template_kwargs":{"enable_thinking":true}}'
Gebruik voor APC de afzonderlijke stock-GDN-profielaanpassing, niet een niet-ondersteunde omgevingsvariabele bij deze standaardcommando's.
Reproduceer de oorspronkelijke 8K-benchmark
De v1.0.0-image blijft ongewijzigd beschikbaar, samen met de release notes van de runtime.11
Versietagghcr.io/eliovp/paiton-vllm-plugin:qwen38-mxfp4-dflash2-rdna4-v1.0.0
docker run -d --name paiton-qwen38-mxfp4 \
  --device /dev/kfd --device /dev/dri --group-add video --shm-size 2g \
  -p 127.0.0.1:8000:8000 \
  -v paiton-qwen38-mxfp4-cache:/models/cache \
  ghcr.io/eliovp/paiton-vllm-plugin@sha256:9b2dae214076d35de785e073b31294b033a376b16e6bc1ec1fdada4e54d96c59
Gebruik de oorspronkelijke modelhandleiding en benchmarkinstellingen om de historische vergelijking te reproduceren. De cache van 5 GiB, limiet van 8.192 tokens, snapshots van doel- en draftmodel, het thinking-gedrag, de speculatieve instellingen en uitgeschakelde APC maken deel uit van het resultaat. De historische serve.py in de repository kiest nog steeds de vastgelegde oorspronkelijke release, niet een van de nieuwe profielen.
Dezelfde hardware. Duidelijk meer capaciteit.
57% meer totale doorvoer. Een 97% kortere mediane tijd tot het eerste token bij acht gelijktijdige verzoeken. 2,89× de geschatte cachecapaciteit. Dat blijven de resultaten van de oorspronkelijke, gelijk opgezette 8K-vergelijking met 188 verzoeken op één Radeon AI PRO R9700 via regulier vLLM.
Die historische stappen leidden tot de actuele ROCm 10-release: 400,7 tok/s in totaal in een afzonderlijke 65K-test en een publiek uitvoerbaar experimenteel chatprofiel voor langere gesprekken. Verschillende checkpoints en workloads blijven gescheiden; de scope van de oorspronkelijke 57%-vergelijking verandert niet.
Voor lokale ontwikkelaars betekent dit een krachtiger gedeeld endpoint op één workstation-GPU. Voor teams die AMD-inference op grotere schaal draaien, laat het opnieuw zien waarom efficiënte uitvoering naast hardwarecapaciteit telt. De R9700-cijfers voorspellen geen winst op andere AMD-platforms.
Wil je meer uit je AMD-inferenceworkload halen? Bespreek met ons wat Paiton kan betekenen. Neem het model, de workload en de huidige referentiemetingen mee.
Dank aan de betrokken teams
Dank aan het Radiance-team voor het uitstekende werk aan AMD-inference, de inspiratie en een sterke vergelijkingsbasis.
We bedanken ook vLLM, StillDeadcode/libr4d, de Qwen- en DFlash2-teams, het Quark-checkpointteam van AMD en BetterBench voor de bouwstenen, modellen en meetinstrumenten waarop dit werk steunt.
De publieke vermeldingen van derden benoemen de aangepaste technieken uit Radiance/libr4d en de toepasselijke voorwaarden per component. Dit artikel beschrijft alleen gepubliceerd serving-gedrag en metingen. Niet-openbare compilerdocumentatie en implementatiedetails blijven privé.
Praat verder met de community
Vragen, ervaringen met de deployment of een workload die we hierna zouden moeten meten? Sluit aan bij de r/ROCm-discussie over deze Qwen3.8-resultaten. De discussie gaat over twee afzonderlijke vergelijkingen. Beide behouden hun eigen methode en zijn niet uitwisselbaar met de korte benchmark van 17 september of de APC-experimenten.
Bronnen
- Actuele release, benchmarktabellen en controles met lange context, publieke launcher en imagedigests. Release van 18 september; geraadpleegd op 19 september 2026. Grafieken zijn gereproduceerd uit de afgeronde publieke tabellen, niet uit een onafhankelijk herhaalde benchmark. 2 3
- De aangeleverde benchmarksamenvatting en grafieken van ElioVP, met de gepubliceerde Paiton-benchmarkonderbouwing. De volledige workload gebruikt runs 495 / 494; de vergelijking met beperkte uitvoerlengte gebruikt runs 403 / 493 / 492. De oorspronkelijke cijfers van 16 september komen uit de aangeleverde samenvatting, niet uit een hier gepubliceerd onbewerkt verzoeklog. De nieuwe grafieken van 17 september gebruiken de hieronder gelinkte publieke gegevens. 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23
- Documentatie van vLLM-Radiance, met hetzelfde AMD Quark MXFP4-doelmodel, het DFlash2-profiel en expliciet gepubliceerde metingen op twee R9700's. Die externe metingen bieden context, maar vormen niet de referentie voor onze procentuele winst.
- BetterBench. De aantallen verzoeken, geselecteerde workloadinstellingen en bovenstaande resultaten komen uit onze aangeleverde runsamenvatting.
- Officiële documentatie van het vLLM-pluginsysteem.
- Productinformatie over Paiton.
- Gepubliceerde startinstructies voor 64K/200K v1.1.0 en onveranderlijke vastlegging van de images. Geraadpleegd op 17 september 2026. 2 3 4
- Rapport over de korte benchmark van de 64K-image en toolondersteuning, de samenvatting, resultaten en oorspronkelijke SVG. De nieuwe grafieken zijn opnieuw getekend op basis van de gepubliceerde gegevens, in de huisstijl van ElioVP. 2 3 4
- APC-onderzoek, gepubliceerde grafiekgegevens, oorspronkelijke SVG en werkende reproductie-instructies voor stock-APC. De native-prefill-APC-resultaten vereisen een niet-vrijgegeven adapter. 2 3
- Bijbehorende Paiton-modelrelease op Hugging Face.
- Paiton Qwen3.8 MXFP4 + DFlash2-runtimerelease, met het runtimepakket en de release notes.

